CALLAII® için iki yeni sürüm hazır. Biri yeni asıl modelimiz CALLAII v8. Öteki yedek ve kurum içi modelimiz CALLAII Edge v2. İkisi de aynı eğitim turundan çıktı. Bu yazıda turun bütün hesabını veriyoruz. Neyi öğrettiğimizi ve nasıl ölçtüğümüzü anlatıyoruz. Nerede başaramadığımızı da yazıyoruz. İyi sonuçlar da zayıf sonuçlar da aynı tabloda duruyor.
İki yeni sürüm
CALLAII v8: yeni asıl model
CALLAII v8 ürünün bütün ekranlarına hizmet eden asıl model. Kendi sunucumuzda çalışır. Çağrıyı dinler, puanlar ve özetler. Koçluk notunu yazar. Hukuk ekranlarında dilekçe hazırlar ve usul denetimi yapar. Enerji dağıtım ekranlarında arıza kaydından saha görevi çıkarır. Haritayı ve belgeyi görüntüden okur.
v8 canlıda bir önceki asıl model CALLAII v7'nin yerini alıyor. En büyük değişiklik çağrı analizinde. Müşterinin ne istediğine talep türü diyoruz. v7 bunu gerçek çağrılarda yüzde 22,7 doğru buluyordu. v8 yüzde 81,8 doğru buluyor. Analiz çıktısı artık bozulmuyor. 534 analizde v7'nin 3 çıktısı geçersizdi. v8'in hiçbiri geçersiz değil. Hukuk belgelerinde kaynakla tutmayan atıf ve alıntı yarıya indi. Harita sorularında puan 60'tan 90'a çıktı.
Canlıya geçerken bir kez daha ölçtük. Canlı sunucuda, canlıdaki istemle 14 gerçek çağrıyı iki modele de analiz ettirdik. v7 38 sorunun 24'ünü doğru buldu. v8 34'ünü doğru buldu. Tek bir isteğe cevap hızı saniyede 76,7 tokendan 81,6 tokena çıktı.
CALLAII Edge v2: yedek ve kurum içi model
CALLAII Edge v2 iki iş yapar. Birincisi kurumun kendi sunucusuna kurulur. Veri kurum dışına çıkmaz. İkincisi bizim yedek sunucularımızda çalışır. Asıl sunucuda bir sorun olursa istekler Edge v2'ye geçer. Ürün kesintisiz çalışmaya devam eder.
Edge v2 bir önceki Edge sürümünün yerini aldı. Yedek sunuculardan birinde 15 Ekim'den beri çalışıyor. Ötekinde uygun ekran kartı açılınca o da geçecek.
Edge v1 bugünkü analiz şablonunu neredeyse hiç dolduramıyordu. 534 analizin yalnız 1'inde eksiksiz çıktı verdi. Edge v2 527'sinde verdi. Hukuki bir soruya Edge v1 usul kontrolüyle hiç başlamıyordu. Edge v2 70 sorunun 69'unda başlıyor. Eğitim bağlamı 4.096 tokendan 28.672 tokena çıktı. Uzun çağrılar artık kesilmeden okunuyor.
Nasıl atladık
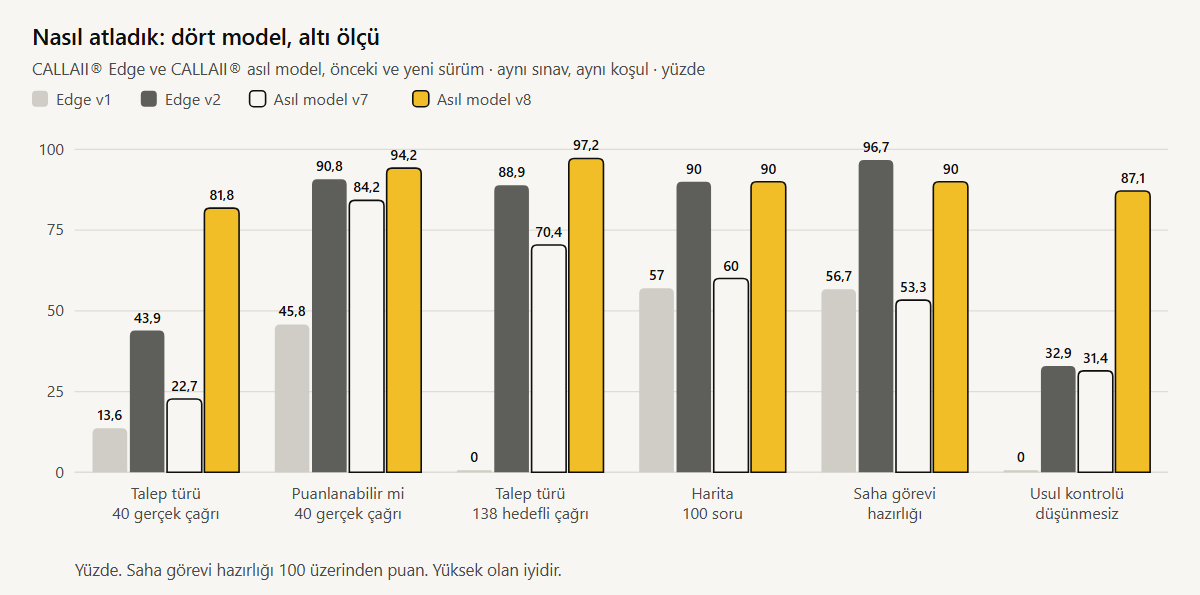
Grafikte dört model var. Griler Edge ailesi. Açık gri Edge v1, koyu gri Edge v2. Sarılar asıl model. Boş çubuk v7, dolu sarı çubuk v8. Altı ölçünün hepsinde yeni sürüm öncekinin üstünde.
Asıl modelde en büyük atlama talep türünde. Gerçek çağrılarda v7 yüzde 22,7 doğruydu, v8 yüzde 81,8 doğru. İkinci büyük atlama düşünme kapalıyken yapılan usul denetiminde. Cevaba usul kontrolüyle başlama yüzde 31,4'ten yüzde 87,1'e çıktı.
Edge tarafında en büyük fark hedefli çağrılarda talep türünde. Edge v1 çoğu analizi geçerli biçimde yazamadığı için 108 sorunun hiçbirini bilemedi. Edge v2 96'sını bildi.
Bu turda neyi öğrettik
Turun ana konusu çağrı analiziydi. Bir çağrıyı dinleyen model dört soruya doğru cevap vermeli. Birincisi bu çağrı puanlanabilir mi. Yanlış numara, sessiz hat ya da iç test çağrısı puanlanmamalı. İkincisi çağrının risk düzeyi ne. Üçüncüsü müşterinin sorunu çözüldü mü. Dördüncüsü müşteri ne istiyordu, yani talep türü ne.
Önceki turlarda bu dört alanda modelin dağılımı gerçek çağrılardan kaymıştı. Bu kez sınıflandırma alanlarını elle verilen etiketlere göre düzelttik. Gerçek çağrıları tek tek etiketledik. Modelin öğrendiği dağılımı bu etiketlerle karşılaştırdık. Dağılım kayınca derleme durdu.
Çağrı puanlamasının kriterlerini de baştan yazdık. Her kriter için hangi davranışın eksik olduğu önceden bilinen örnekler hazırladık. Model artık bir puanı neden verdiğini bu örneklerden öğreniyor.
Hukuk tarafında beş yüzey vardı. Dilekçe, ihtarname, sözleşme, derin araştırma ve usul denetimi. Dilekçe ve sözleşme örneklerinin çoğuna bu tur düşünme adımları eklendi. Model önce olayı ve dayanağı düşünüp sonra metni yazıyor. Kaynakta olmayan kanun maddesi geçen örnekler eğitimden çıkarıldı.
Bunların yanında adres ayrıştırma, enerji dağıtım ekranları, harita ve görüntü okuma öğretildi. Kimlik ve saldırı dayanıklılığı için de ayrı örnekler vardı. Model her dilde kendini doğru tanıtmalı. İç kurallarını paylaşmamalı. Bir kurumun sohbet penceresinde başka bir kurumun adını anmamalı.
Eğitim verisi
| CALLAII® Edge v2 | CALLAII® v8 | |
|---|---|---|
| Eğitim örneği | 70.236 | 61.461 |
| Görüntülü örnek | 8.000 | 8.000 |
| Eğitim bağlamı | 28.672 token | 32.768 token |
| Adım | 4.390, 1 devir | 3.842, 1 devir |
| Doğrulama seti | 186 örnek | 186 örnek |
| Bağlamı aştığı için atılan örnek | 60 | 12 |
Bir önceki Edge sürümü ve v7 45.847 örnekle, 4.096 token bağlamla eğitilmişti. Bağlam Edge'de yedi, v8'de sekiz katına çıktı. Uzun çağrılar ve hukuk metinleri artık kesilmeden öğretiliyor.
Sınav için ayrılan çağrılar eğitime girmedi. Derleme sırasında sınavla kesişen örnekler ayıklandı.
Eğitim eğrileri
Edge v2'nin doğrulama kaybı 100. adımda 0,606 idi. Son adımda 0,356 oldu. Eğri eğitimin son çeyreğinde düzleşti. Ezberlemeye dönen bir yükseliş görmedik. En düşük değer 0,355 ile son değerden ayırt edilemeyecek kadar yakın.
v8'in doğrulama kaybı 100. adımda 0,460 idi. Eğitim 3.842. adımda bitti ve son değer 0,293 oldu. En düşük değer de bu. Eğri son çeyrekte düzleşti ama hafifçe düşmeye devam etti. Burada da ezberlemeye dönen bir yükseliş yok.
Kayıp eğrisi bir modelin iyi olduğunu tek başına kanıtlamaz. Yalnız eğitimin sağlıklı ilerlediğini gösterir. Asıl soru sınavda cevaplanır.
Nasıl ölçtük
Sınavları eğitimden önce kurduk ve sabitledik. Eğitim bittikten sonra sınava dokunmadık.
Çağrı analizi sınavında iki küme var. Birincisi 40 gerçek çağrı. Bunların doğru cevabı sınavdan önce tek tek belirlendi. Bu cevaplar kör bir ikinci etiketle karşılaştırıldı. İkincisi 138 hedefli sınav çağrısı. Bunlar modelin önceki turlarda zorlandığı durumlardan seçildi. Uzun soluklu geri aramalar, enerji arızaları ve satış görüşmeleri bunlara örnek.
Dört model aynı çağrıları aynı istemle aldı. Çağrı analizi üç kez koşuldu ve üç koşunun toplamı yazıldı. Düşünmeli usul sınavı da üç kez koşuldu, ortanca alındı. Görüntü, adres ve enerji sınavları tek koşu.
Dört modeli aynı gün, aynı sınav sunucusunda ölçtük. Geçerli bir cevap vermeyen model o soruda yanlış sayıldı. Bu kural dört modele de aynı uygulandı.
Tek bir koşul farkı var. Sınavda v7, v8 ve Edge v2 sayıları 8 bitlik biçimde tutarak çalıştı. Edge v1 16 bitlik biçimde çalıştı. Daha kaba sayı biçimi sonucu biraz düşürebilir. Yani bu fark varsa Edge v1'in lehine.
Sonuçlar
Çağrı analizi
| 40 gerçek çağrı | Edge v1 | Edge v2 | v7 | v8 |
|---|---|---|---|---|
| Puanlanabilir mi (120) | 55 | 109 | 101 | 113 |
| Risk düzeyi (66) | 24 | 50 | 51 | 54 |
| Çözüm durumu (66) | 12 | 37 | 36 | 45 |
| Talep türü (66) | 9 | 29 | 15 | 54 |
| 138 hedefli çağrı | Edge v1 | Edge v2 | v7 | v8 |
|---|---|---|---|---|
| Puanlanabilir mi (51) | 9 | 45 | 33 | 40 |
| Risk düzeyi (213) | 66 | 147 | 142 | 158 |
| Çözüm durumu (123) | 36 | 71 | 73 | 76 |
| Talep türü (108) | 0 | 96 | 76 | 105 |
Parantez içindeki sayı üç koşudaki toplam soru sayısı. Risk ve çözüm sorusu yalnız puanlanabilir çağrılarda sorulduğu için paydalar farklı.
v8 dört alanın dördünde v7'nin önünde. En büyük fark talep türünde. Hedefli çağrılarda 108 sorunun 105'ini doğru buldu. Eksiksiz analiz çıktısı v7'de 534'te 531 idi. v8'de 534'ün hepsi eksiksiz.
Edge v2 her alanda Edge v1'in çok önünde. v7 ile karşılaştırınca talep türünde ve puanlanabilir çağrıyı ayırmada önde. Risk ve çözümde başa baş. Edge v2'nin 534 analizinin 527'si eksiksiz çıktı.
Çözüm durumu hâlâ en zayıf alan. v8 gerçek çağrılarda yüzde 68,2, hedefli çağrılarda yüzde 61,8 doğru. Bu oran bir yöneticinin tek başına güveneceği düzeyde değil. Bu alan ekranda öneri olarak kalmalı.
Hukuk
Avukat bir soru sorduğunda model cevaba görevli mahkeme ve süre gibi usul kontrolleriyle başlamalı. Düşünmeli kipte üç model aynı yerde. v7 ve v8 70 sorunun 70'inde, Edge v2 69'unda usul kontrolüyle başlıyor. Edge v1 hiçbirinde başlamıyordu. Usul noktalarını doğru saymada v8 70'te 62 ile en önde.
Asıl fark düşünme kapalıyken çıkıyor. Bu kipte v8 70 sorunun 61'inde usul kontrolüyle başlıyor. v7 22'sinde, Edge v2 23'ünde başlıyordu.
Belgelerde 70 belgelik bir küme kullandık. 20 araştırma, 20 dilekçe, 15 ihtarname ve 15 sözleşme. Her belge kod tabanlı bir denetimden geçti. Denetim karar numarasını, kanun maddesini ve tırnak içindeki alıntıyı gerçek metinle karşılaştırıyor. Tutmayan her biri kritik hata sayılıyor.
| 70 hukuk belgesi | Edge v1 | Edge v2 | v7 | v8 |
|---|---|---|---|---|
| Kritik atıf ve alıntı hatası, canlı ayar | 2 | 4 | 8 | 4 |
| Kritik atıf ve alıntı hatası, düşünmesiz | 3 | 1 | 8 | 3 |
| Uzunluk sınırında kesilen belge, canlı ayar | 1 | 0 | 1 | 0 |
v8 kritik hatayı v7'ye göre yarıya indirdi. Canlı ayarda 8'den 4'e, düşünmesiz koşuda 8'den 3'e indi. Kesilen belge kalmadı. Edge tarafında iki sürüm arasında anlamlı bir fark yok. Sayılar o kadar küçük ki bir iki belge sonucu değiştiriyor.
Bu tablo yalnız atıf ve alıntı doğruluğunu ölçüyor. Dilekçenin ikna gücünü ya da olayı doğru kurup kurmadığını ölçmüyor. Bu yüzden her hukuk belgesi avukat kontrolünden geçmeli. Ürün bunu zaten şart koşuyor.
Görüntü, enerji ve adres
Harita soruları kendi çizdiğimiz haritalardan üretiliyor ve cevapları kesin. Yol, yön, konum ve kesinti bölgesi soruları var. v8 haritada 60'tan 90'a, şekil saymada 80'den 95'e çıktı. Diğer görüntü sorularında 82,3'ten 100'e çıktı. Edge v2 haritada 57'den 90'a, şekil saymada 58,3'ten 88,3'e çıktı.
Enerji ekranlarında v8'in en büyük artışı rota planı değerlendirmede. Puan 20'den 93,3'e çıktı. Saha görevi hazırlığı 53,3'ten 90'a, temsilci asistanı 80'den 96,7'ye çıktı. Yönetici rota 93,3'te aynı kaldı. Adres ayrıştırmada 38 adreste puan 92,1'den 96,2'ye çıktı.
Edge v2'de en büyük artış saha görevi hazırlığında oldu. Puan 56,7'den 96,7'ye çıktı. Yönetici rota 60'tan 96,7'ye, adres 88'den 95'e çıktı. Bu ekranların üçünde Edge v2 v8'in de önünde. Rota planı değerlendirme, saha görevi hazırlığı ve yönetici rota.
Enerji sınavı yalnız kod kapısıyla puanlandı. Kapı cevabın biçimini, önceliğini ve zorunlu alanlarını denetliyor. Cevabın içinde uydurma bir sayı olup olmadığını bir hakem okumadı.
Kimlik ve saldırı dayanıklılığı
Modelin her dilde kendini CALLAII olarak tanıtmasını ölçtük. Saldırı denemelerine direncini de ölçtük. İki yeni sürümde de başka bir yapay zekanın adıyla konuşma neredeyse tamamen kalktı. Saldırı denemelerinde ikisi de iç kurallarını paylaşmadı. Ayrıntıları güvenlik gereği burada vermiyoruz. Ürün bu konuda modele tek başına güvenmiyor. Cevap kullanıcıya gitmeden önce ayrıca denetleniyor.
Edge v2 yedek sunucuda nasıl çalışıyor
Bu bölüm biraz teknik. Ama bir modelin sahada nasıl çalıştığını göstermenin iyi bir örneği.
Yedek sunucunun ekran kartı asıl sunucununkinden küçük. Modelin bir seferde okuyabileceği metin uzunluğuna bağlam diyoruz. Bağlam karttaki belleğe bağlı. Bu yüzden yedek sunucu her açılışta önce kendi kartının belleğini ölçüyor. Bağlamı ona göre seçiyor. 40 GB'tan büyük bir kartta yaklaşık 65 bin token. Daha küçük kartta yaklaşık 40 bin token.
Sınırı ezbere koymadık. Küçük kartta görselli ve uzun bir istekle gerçek belleği ölçtük. 40 bin tokenda belleğin 1 GB'tan biraz fazlası boş kaldı. Payın 1 GB'ın altına düştüğü ayarı kullanmıyoruz.
Modelin karta sığması için sayılarını sıkıştırıyoruz. İki seviye denedik. Daha sıkı sıkıştırılmış sürüm daha az bellek istiyordu. Ama 20 yapılandırılmış cevabın 5'inde alan adlarını bozdu ya da çıktıyı geçersiz yazdı. Daha az sıkıştırılmış sürümde bu 20'de 0 oldu. Biz daha az sıkıştırılmış sürümü seçtik. Bozuk bir alan adı ekranda yanlış bir kayıt demek. Biraz daha bellek ödemeye değer.
Edge v2 cevap vermeden önce düşünüyor. Edge v1 düşünmüyordu. Bazı hukuk işlerinde bu düşünme çok uzuyor ve cevap gecikiyordu. Yedek sunucuda düşünmeye bir üst sınır koyduk. Sınıra gelince model düşünmeyi bırakıp cevaba geçiyor.
Neyi başaramadık
Küçük işletme modeli bu tura giremedi. Küçük işletmeler için daha küçük bir model de eğitecektik. Eğitim altıncı adımda beş kez aynı yerde durdu. En uzun örneklerden birinde ekran kartı belleği yaklaşık 9,8 GB eksik kaldı. Bağlamı kısaltmak kolay bir çözüm gibi görünüyor ama değil. Uzun örneklerin çoğu çağrı analizi ve tam da öğretmek istediğimiz şey. Kalıcı çözüm eğitimin bellek kullanımını değiştirmek. Bunu en uzun örnekle tek adımda sınamadan yeni bir eğitim başlatmayacağız.
Hukuk belgelerinin kalitesini hakemle puanlamadık. Atıf denetimi yalnız kaynağın doğru olup olmadığına bakıyor. Belgenin iyi yazılıp yazılmadığını bilmiyoruz. v8'de kritik hata yarıya indi ama bu belgenin daha iyi olduğu anlamına gelmiyor.
v8'de çözüm kararı hâlâ zayıf. Hedefli çağrılarda 123 sorunun 76'sını doğru buldu. v7 73'ünü buluyordu. Talep türünde büyük sıçrama yapan model bu alanda neredeyse yerinde saydı.
Edge v2 CALLAII adının açılımında geriledi. Edge v1 kendi adının açılımını her seferinde doğru söylüyordu. Edge v2 bazı dillerde yanlış söyledi.
Kart çevirisinde terim hataları çıktı. Model kartlarını altı dile kendi modelimizle çeviriyoruz. Edge v2 kartının çevirisinde hatalar yakaladık. Bir dilde "düşünmesiz kip" tam tersine çevrilmişti. Bir başka dilde bir düşüş artış gibi yazılmıştı. Artık her çeviri yayından önce otomatik denetimden geçiyor. Sayılar, yön sözcükleri ve terimler kaynakla karşılaştırılıyor. Terimler için ortak bir sözlük kurduk.
Edge v2 her alanda v7'yi geçmedi. Geçersiz çıktı veren analiz 534'te 7, v7'de 3. Hedefli çağrılarda çözüm durumunda ve gerçek çağrılarda risk düzeyinde bir iki soru geride.
Edge'in kendi sınırları. Edge kurumun sunucusunda sıkıştırılmış biçimde çalışır. Bu ölçümler sınav sunucusunda yapıldı. Kurumun sunucusunda sonuç biraz farklı olabilir.
Sırada ne var
İki modelin kartı sitedeki model sayfasında bu sınavlarla birlikte duruyor.
Bir sonraki turun konuları belli. Hukuk belgelerini bir hakemle puanlamak. Çözüm durumu için daha çok elle doğrulanmış çağrı toplamak. Küçük işletme modelinin bellek sorununu çözmek.
Bir modelin neyi iyi yaptığını söylemek kolay. Neyi yapamadığını göstermek daha zor. Biz ikisini birlikte göstermeyi seçiyoruz.
